「複数のCSVを1つにまとめたいけれど、ファイルごとに列名や列順が違う。」
そんなことはありませんか?
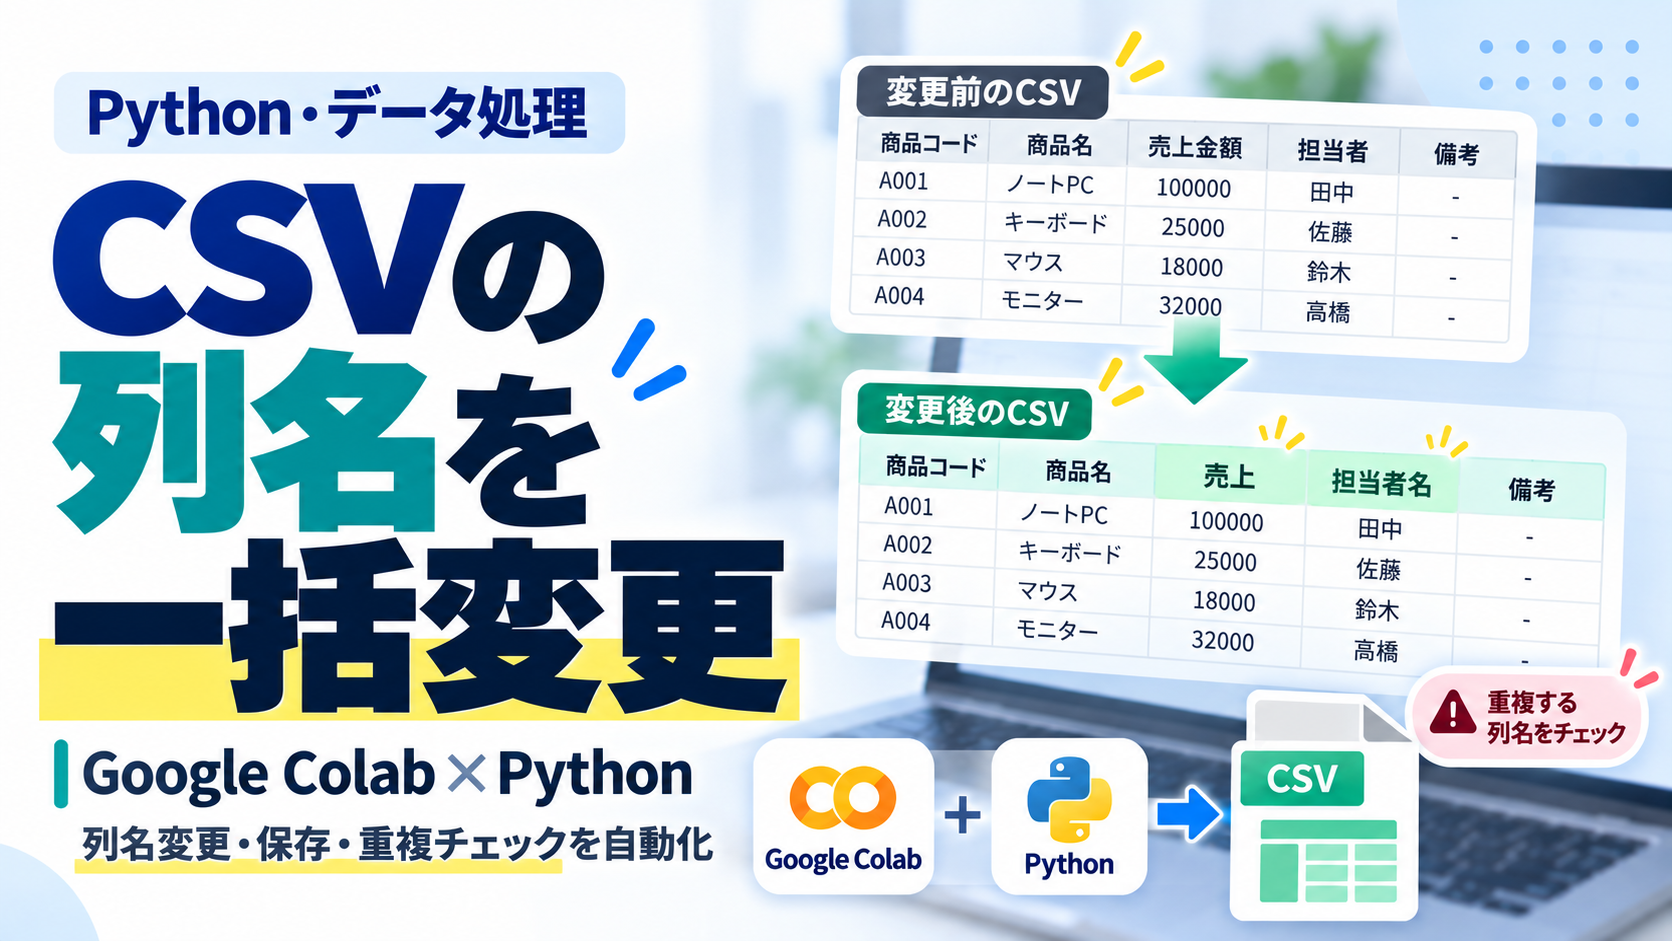
取引先や店舗ごとにCSVを受け取っていると、同じ意味のデータでも、
- 「商品 名」と「商品名」が混在している
- 「売上」と「売上金額」で列名が違う
- 列の並び順がファイルごとに違う
- 必要な列が抜けている
- 列名を変更した結果、同じ列名が重複する
といった問題が起こることがあります。
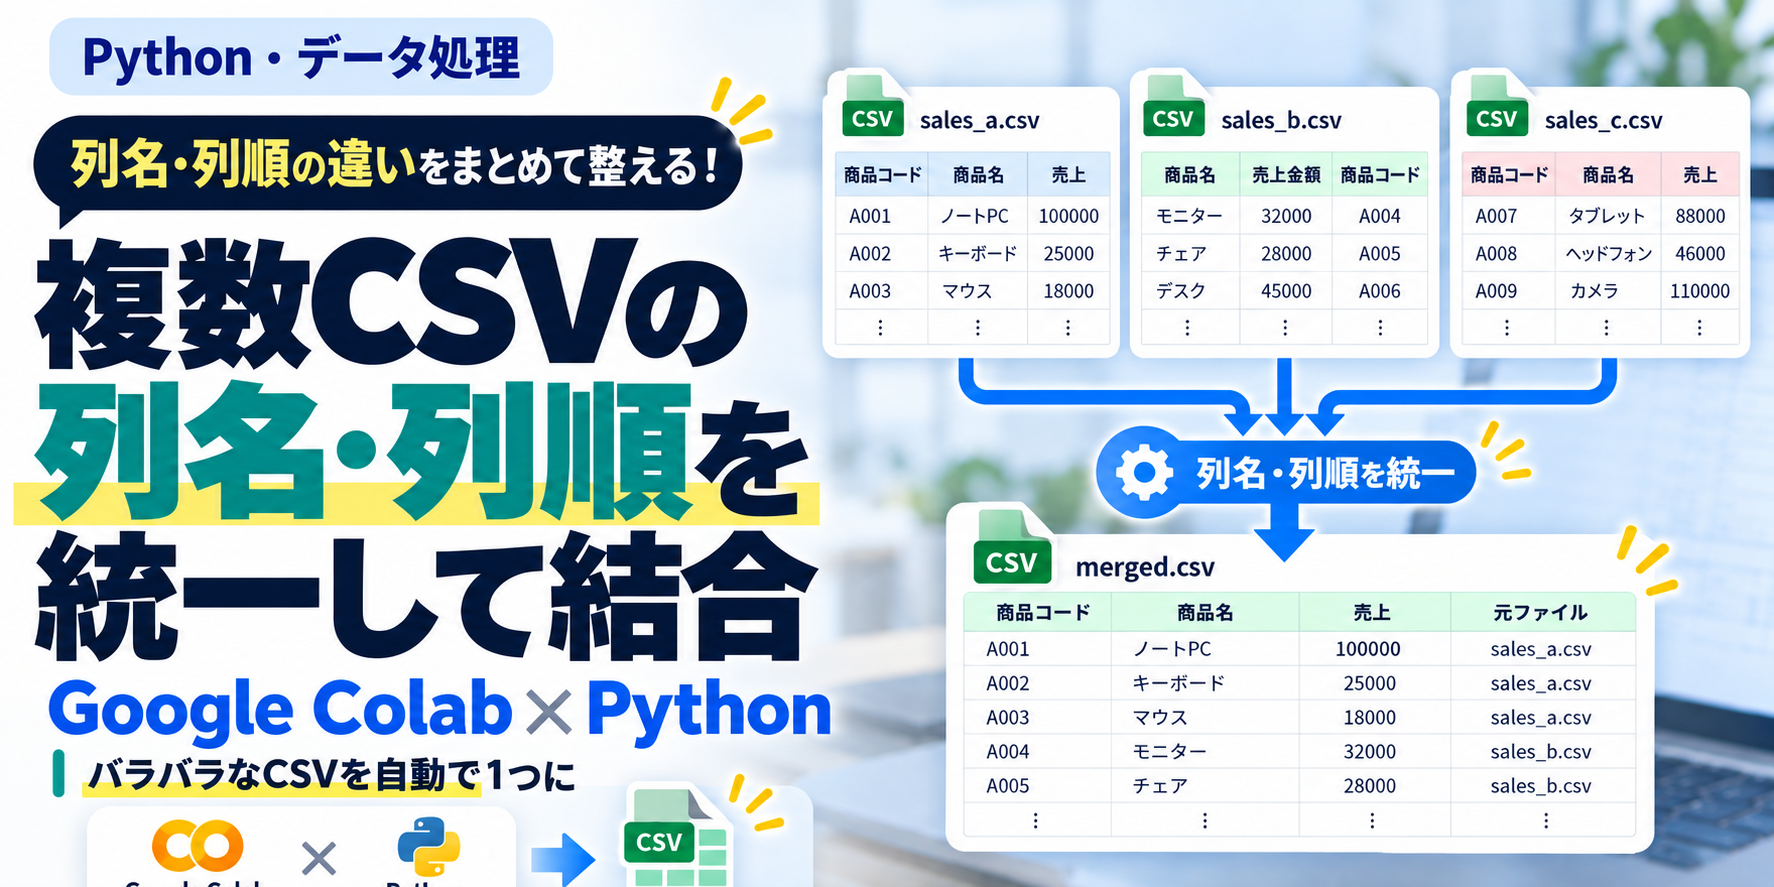
この記事では、Google ColabとPythonを使って、複数CSVの列名・列順を安全に統一してから1つに結合する方法を紹介します。
✅ この記事は実際に動作検証しています
列名・列順が異なる3つのCSVをGoogle Colabで読み込み、列名変更ルールを適用したうえで、列順を統一して1つに結合しました。存在しない列名や重複列名の確認も行い、結合前後の件数・売上合計と、保存後のデータ一致を確認しています。
検証結果:3CSV → 6件に結合 / 売上合計:10,300円 / 件数・売上照合:一致 / 保存後データ一致:True
この記事はこんな人向け
- 取引先や店舗ごとにCSVの列名が違う
- CSVごとに列順がバラバラ
- 複数CSVを結合する前に見出しを揃えたい
- 存在しない列や重複列名を事前に確認したい
- どのファイルから来たデータか残したい
- 結合前後の件数・金額まで確認したい
今回の処理の流れ
列名・列順が異なるCSV
↓
列名変更ルールを作る
↓
存在しない列名を確認
↓
変更後の重複列名を確認
↓
列名を統一
↓
必要な列が揃っているか確認
↓
列順を統一
↓
元ファイル名を追加
↓
3ファイルを結合
↓
件数・売上合計を照合
↓
別CSVとして保存
↓
再読み込みして内容を確認
今回使う3つのCSV
東京CSV
| 商品コード | 商品名 | 売上 |
|---|---|---|
| A001 | りんご | 1200 |
| A002 | みかん | 1500 |
大阪CSV
| 商品名 | 売上金額 | 商品コード |
|---|---|---|
| ぶどう | 2000 | A003 |
| もも | 1800 | A004 |
福岡CSV
| 商品コード | 商品 名 | 売上 |
|---|---|---|
| A005 | いちご | 2200 |
| A006 | なし | 1600 |
3ファイルを合わせると、データ件数は6件、売上合計は10,300円です。
列名変更ルールを対応表で作る
rename_map = {
    "商品 名": "商品名",
    "売上金額": "売上"
}
対応表に含まれていない列はそのまま残ります。
存在しない列名を事前にチェックする
missing_columns = [
    old_name
    for old_name in rename_map.keys()
    if old_name not in df.columns
]

print("【存在しない列名】")

if missing_columns:
    print("指定したが見つからない列:", missing_columns)
else:
    print("すべての変更対象列が存在します")
変更後の列名が重複しないか確認する
test_columns = [
    rename_map.get(col, col)
    for col in df.columns
]

duplicated_columns = [
    col
    for col in set(test_columns)
    if test_columns.count(col) > 1
]

print("【変更後の列名重複】")

if duplicated_columns:
    print("重複する列名:", duplicated_columns)
else:
    print("重複する列名はありません")
3つのCSVを読み込み、列名・列順を統一する
import pandas as pd
from pathlib import Path

standard_columns = [
    "商品コード",
    "商品名",
    "売上"
]

rename_map = {
    "商品 名": "商品名",
    "売上金額": "売上"
}

files = sorted(
    Path(".").glob("*_sales.csv")
)

normalized_list = []

for file in files:

    temp_df = pd.read_csv(
        file,
        encoding="utf-8-sig",
        dtype=str,
        keep_default_na=False
    )

    print("【処理前】", file.name)
    print(temp_df.columns.tolist())

    temp_df = temp_df.rename(
        columns=rename_map
    )

    missing_columns = [
        col
        for col in standard_columns
        if col not in temp_df.columns
    ]

    if missing_columns:
        print(
            "注意:必要な列が不足しています:",
            missing_columns
        )
        continue

    temp_df = temp_df[
        standard_columns
    ]

    temp_df["元ファイル"] = file.name

    normalized_list.append(temp_df)

    print("【処理後】")
    print(temp_df.columns.tolist())
    print()
必要な列がないCSVは結合対象から外す
必要な列が欠けたまま無理に結合するより、対象外として確認できる方が安全です。
元ファイル名を自動追加する
temp_df["元ファイル"] = file.name統一した3つのCSVを1つに結合する
combined_df = pd.concat(
    normalized_list,
    ignore_index=True
)

print("結合したファイル数:", len(normalized_list))
print("結合後のデータ件数:", len(combined_df))
display(combined_df)
今回の結果は、3ファイル・6件に結合できました。
結合前後の件数と売上合計を照合する
before_count = sum(
    len(data)
    for data in normalized_list
)

before_sales = sum(
    data["売上"].astype(int).sum()
    for data in normalized_list
)

after_count = len(combined_df)
after_sales = combined_df["売上"].astype(int).sum()

count_match = before_count == after_count
sales_match = before_sales == after_sales

print("データ件数の一致:", count_match)
print("売上合計の一致:", sales_match)
今回の検証では、結合前後ともに6件・10,300円で一致しました。
結合結果を新しいCSVとして保存する
output_file = "combined_normalized.csv"

combined_df.to_csv(
    output_file,
    index=False,
    encoding="utf-8-sig"
)
元の3つのCSVは上書きせず、そのまま残します。
保存したCSVを再読み込みして確認する
saved_df = pd.read_csv(
    "combined_normalized.csv",
    encoding="utf-8-sig",
    dtype=str,
    keep_default_na=False
)

data_match = (
    combined_df.astype(str)
    .reset_index(drop=True)
    .equals(
        saved_df
        .reset_index(drop=True)
    )
)

print("保存前後のデータ一致:", data_match)
今回の結果は True でした。
列名の表記ゆれとデータの表記ゆれは別
今回揃えているのはCSVの列名です。データ内部の A001 / a001 / A001 のような違いは、別途整形が必要です。
自分のCSVで変更する場所
| 今回の設定 | 自分のCSVでは |
|---|---|
*_sales.csv |
結合対象ファイル名の条件 |
standard_columns |
統一後の列名・列順 |
rename_map |
変更前→変更後の列名ルール |
元ファイル |
読み込み元を記録する列名 |
combined_normalized.csv |
保存ファイル名 |
まとめ
今回は、Google ColabとPythonを使って、複数CSVの列名・列順を安全に統一してから1つのCSVへ結合しました。
いきなり結合するのではなく、存在しない列・重複列名・必要列を確認してから結合することで、後続処理のトラブルを減らしやすくなります。