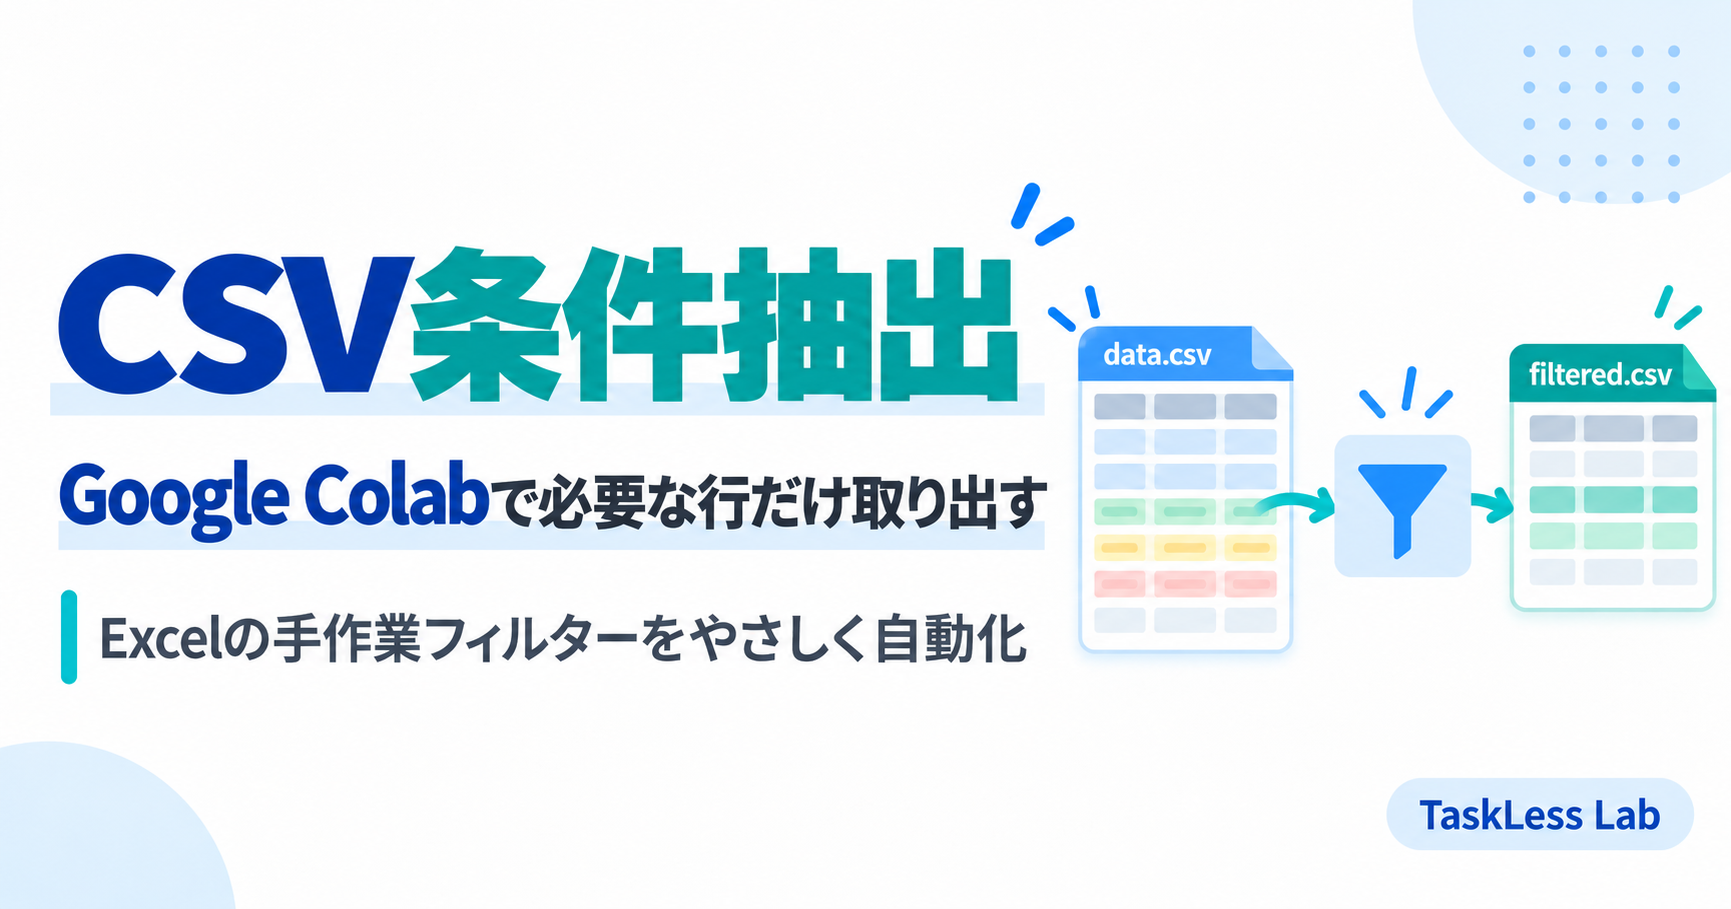
「毎回Excelで同じフィルターをかけて、必要なデータだけ取り出している。」
そんな作業はありませんか?
売上一覧や商品リスト、注文履歴などを確認するとき、
- 売上10,000円以上だけ見たい
- 東京店のデータだけ取り出したい
- 東京店かつ売上10,000円以上だけ確認したい
- 東京店または大阪店だけ残したい
- 売上0円の行を除外したい
- キャンセル済みの注文を取り除きたい
といった処理をすることがあります。
この記事では、Google ColabとPythonを使って、CSVから条件に合う行を抽出したり、逆に条件に合う行を安全に除外したりする方法を紹介します。
✅ この記事は実際に動作検証しています
Google ColabでCSVを使い、数値・文字列による条件抽出、AND・OR条件、条件に合う行の除外まで実際に確認しました。除外処理では、対象行を先に抽出し、処理前後の件数・売上金額を照合しています。元CSVは上書きせず、保存後のCSVも再読み込みしてデータが一致することを確認しました。
検証結果:条件抽出:確認済み / AND・OR:確認済み / 除外処理:6件 → 3件除外 → 3件残存 / 件数・売上照合:一致 / 保存後データ一致:True
「条件抽出」と「条件除外」の違い
| 処理 | 残すデータ | 例 |
|---|---|---|
| 条件抽出 | 条件に合う行 | 売上10,000円以上だけ残す |
| 条件除外 | 条件に合わない行 | キャンセル済みを除外する |
まずは条件に合うデータを抽出する
今回使う売上データ
| 店舗 | 商品コード | 商品名 | 売上 |
|---|---|---|---|
| 東京 | A001 | 商品A | 10000 |
| 大阪 | A001 | 商品A | 12000 |
| 福岡 | A002 | 商品B | 7000 |
| 東京 | A002 | 商品B | 8000 |
| 大阪 | A003 | 商品C | 9000 |
| 福岡 | A004 | 商品D | 11000 |
Google ColabにCSVをアップロードする
import pandas as pd

df = pd.read_csv("all_sales.csv")

display(df)
売上10,000円以上だけ抽出する
filtered_df = df[
    df["売上"] >= 10000
]

display(filtered_df)
東京店だけ抽出する
tokyo_df = df[
    df["店舗"] == "東京"
]

display(tokyo_df)
AND条件|東京店かつ売上10,000円以上を抽出する
tokyo_high_sales_df = df[
    (df["店舗"] == "東京")
    &
    (df["売上"] >= 10000)
]

display(tokyo_high_sales_df)
OR条件|東京店または大阪店を抽出する
tokyo_osaka_df = df[
    (df["店舗"] == "東京")
    |
    (df["店舗"] == "大阪")
]

display(tokyo_osaka_df)
条件に合う行を「除外」する方法
いきなり対象行を消さず、除外対象を先に確認してから、残す行だけで新しいDataFrameを作ります。
除外処理で使うテストデータ
| 注文番号 | 商品名 | 売上 | ステータス | 店舗 |
|---|---|---|---|---|
| A001 | りんご | 1200 | 完了 | 東京 |
| A002 | みかん | 0 | 完了 | 東京 |
| A003 | ぶどう | 2000 | キャンセル | 大阪 |
| A004 | もも | 1800 | 完了 | 大阪 |
| A005 | いちご | 0 | キャンセル | 福岡 |
| A006 | なし | 1600 | 完了 | 福岡 |
売上0円またはキャンセルの行を除外対象にする
delete_condition = (
    (df["売上"] == 0)
    |
    (df["ステータス"] == "キャンセル")
)
除外対象を先に確認する
delete_rows = df[
    delete_condition
].copy()

print("除外対象件数:", len(delete_rows))
print(
    "除外対象の売上合計:",
    delete_rows["売上"].sum()
)

display(delete_rows)
「~」で条件を反転して、残す行だけ取り出す
filtered_df = df[
    ~delete_condition
].copy()

print("除外後のデータ件数:", len(filtered_df))
print(
    "除外後の売上合計:",
    filtered_df["売上"].sum()
)

display(filtered_df)
本当に正しく除外できたか件数・金額で確認する
before_count = len(df)
before_sales = df["売上"].sum()

delete_count = len(delete_rows)
delete_sales = delete_rows["売上"].sum()

after_count = len(filtered_df)
after_sales = filtered_df["売上"].sum()

count_match = (
    before_count - delete_count
    == after_count
)

sales_match = (
    before_sales - delete_sales
    == after_sales
)

print("データ件数の一致:", count_match)
print("売上合計の一致:", sales_match)
処理結果を新しいCSVとして保存する
output_file = "filtered_sales.csv"

filtered_df.to_csv(
    output_file,
    index=False,
    encoding="utf-8-sig"
)
保存したCSVを再読み込みして確認する
saved_df = pd.read_csv(
    "filtered_sales.csv",
    encoding="utf-8-sig",
    dtype=str,
    keep_default_na=False
)

filtered_check_df = filtered_df.astype(str)

data_match = (
    filtered_check_df
    .reset_index(drop=True)
    .equals(
        saved_df
        .reset_index(drop=True)
    )
)

print("保存前後のデータ一致:", data_match)
まとめ
条件抽出と条件除外は、条件に合う側を残すか、合わない側を残すかの違いです。
除外対象を先に確認し、件数や金額を照合し、元データを残し、保存後も再確認する。
この流れにしておけば、条件設定を間違えた場合にも気付きやすくなります。